
Мониторинг хаба
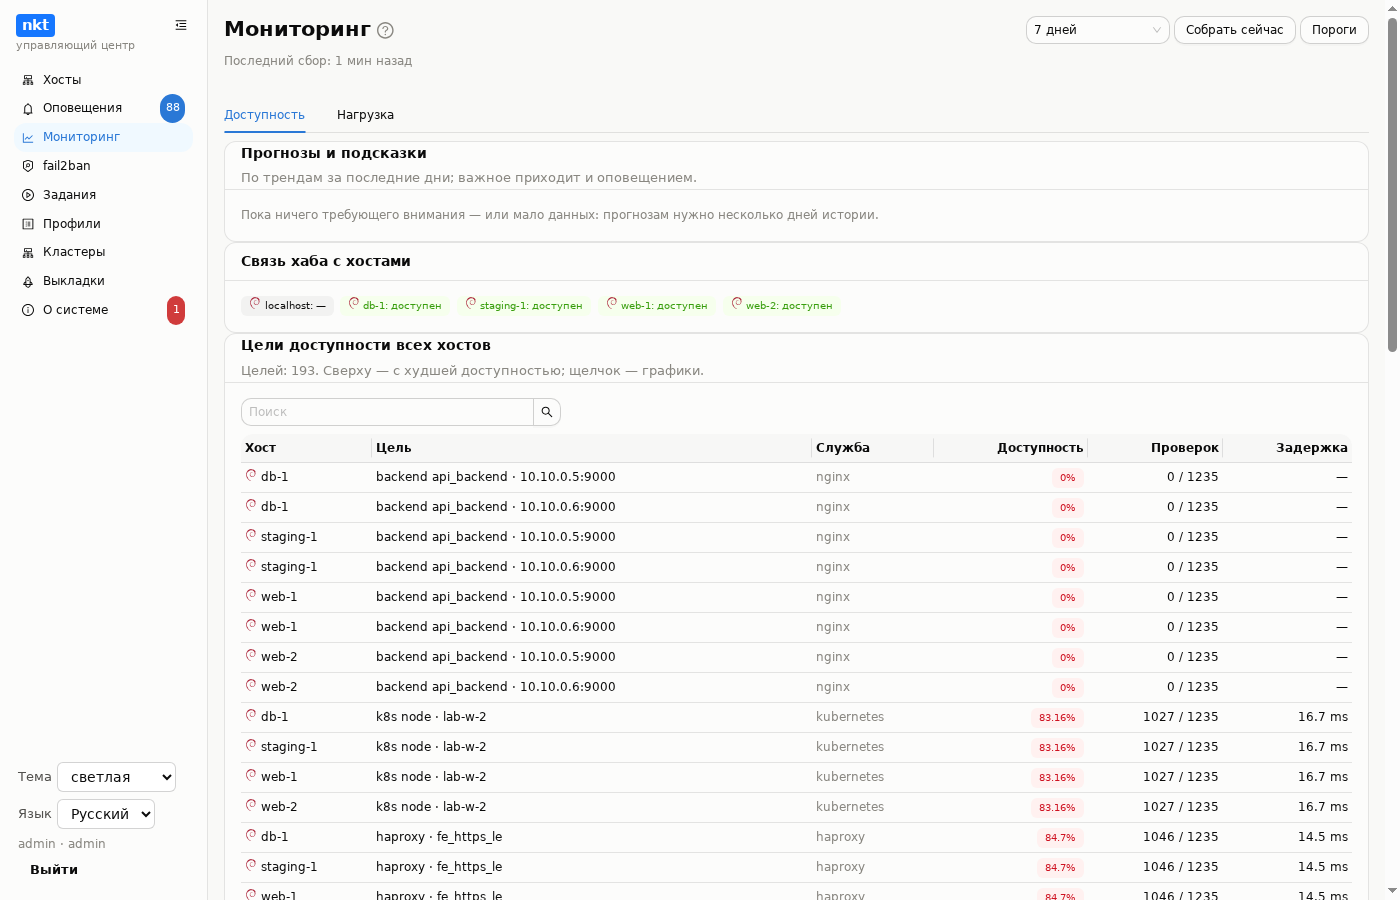
Раздел меню хаба сразу под «Оповещениями» — доступность и нагрузка всех хостов с прогнозами и подсказками. Две вкладки: «Доступность» и «Нагрузка»; сверху — период (сутки, 7, 30, 90 дней, год), «Собрать сейчас» и «Пороги» (администратору).
Откуда данные. Каждый хост раз в минуту пишет ряды своей загрузки (CPU, память, load, заполнение каждой файловой системы) рядом с рядами контейнеров Docker и Podman, LXD, машин и подов Kubernetes и проверками целей доступности. Раз в час хаб забирает с каждого хоста почасовые сводки за недостающие часы (/api/monitor/summary; хост был недоступен — дозабирает, пока они есть на хосте, до 30 дней) и хранит у себя: часы — 90 дней, дни — год (NKT_HUB_HISTORY_HOURLY, NKT_HUB_HISTORY_DAILY). Поэтому раздел показывает и хосты, недоступные сейчас. Хост со старым nkt помечен «обновите nkt».
«Доступность»: связь хаба с каждым хостом; все цели доступности всех хостов — процент за период, проверки, задержка (сверху — худшие, поиск, щелчок — графики доступности и задержки по часам или дням); тепловая карта недоступности по часам недели в вашем местном времени.
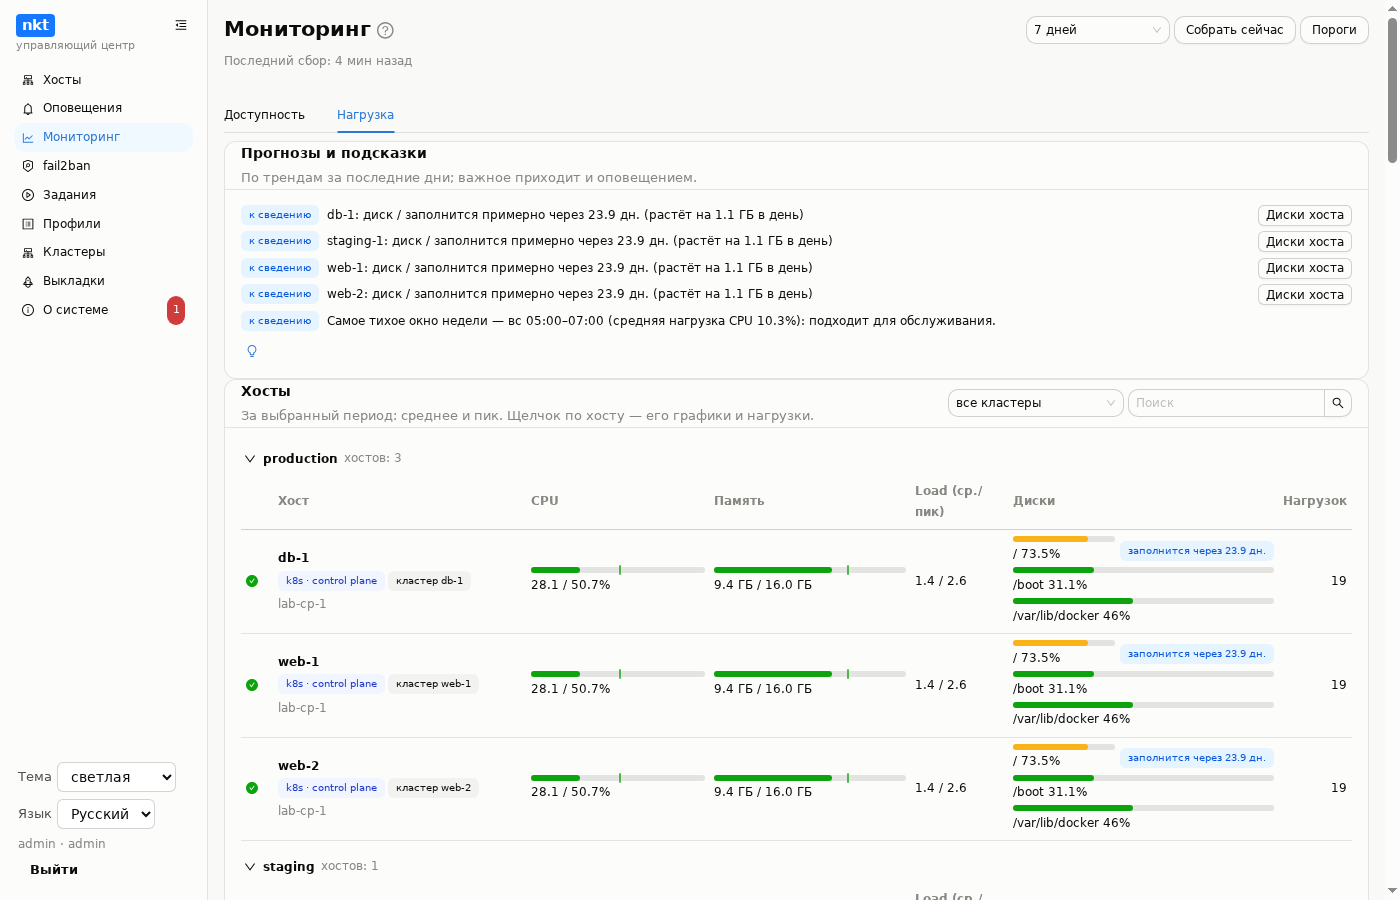
«Нагрузка»: хосты — как в списке хостов хаба: группы хаба сворачиваемыми разделами, значок состояния, CPU и память полосками (полоса — среднее за период, метка — пик; цвет — по порогам из «Порогов»), load, каждый диск полоской с прогнозом «заполнится через N дней»; щелчок — графики хоста (CPU, память с линией объёма, load, диски в процентах) и его нагрузки. Фильтр по кластеру и поиск.
Kubernetes. Control plane отдаёт хабу состав кластера: узлы с ролью и узел каждого пода. Хосты хаба, которые являются узлами, подписаны «k8s · control plane» или «k8s · worker» и именем кластера (узел сопоставляется с хостом по адресу, затем по имени; хосты кластеров, созданных хабом, — по их роли в «Кластерах»). Узлы, которых нет среди хостов хаба, показаны отдельным разделом «кластер … · узлы без хоста на хабе» — с готовностью, адресом, CPU и памятью из kubectl top nodes (доля от ёмкости узла).
Контейнеры и машины всех хостов — по отдельности: Docker, Podman, LXD, машины libvirt, поды Kubernetes и узлы Kubernetes с CPU, памятью и сетью; у подов — колонка «Узел» (рабочие узлы видны как узлы своих подов). Фильтры: вид, кластер, узлы (несколько), namespace, поиск; щелчок — графики. Тепловая карта CPU по часам недели.
Прогнозы и подсказки — вверху каждой вкладки, по трендам за последние дни (устойчивая оценка наклона — медиана наклонов всех пар точек, — единичные всплески её не сдвигают):
- диск заполнится через N дней (по 14 дням истории);
- память хоста выше порога сутки подряд, CPU выше порога в среднем за сутки, рост памяти или CPU неделя к неделе;
- память контейнера или машины растёт без остановки несколько дней — похоже на утечку;
- доступность цели за сутки заметно ниже, чем за неделю; задержка выросла вдвое;
- перенос: хост на пределе по памяти, а у другого хоста запас — какую нагрузку можно перенести;
- самое тихое окно недели (два часа с наименьшей нагрузкой CPU всех хостов) — для обслуживания.
У подсказки — кнопка в раздел хоста, где это решается («Диски», «Контейнеры и ВМ», «Доступность»); хаб сам ничего не меняет. Лампочка под списком — разбор моделью: что важнее, что сделать и что наблюдать дальше (своя инструкция «планирование по „Мониторингу“» в настройках разбора моделью).
Оповещения «прогноз»: диск заполнится раньше порога (предупреждение и «срочно»), память на пределе, похоже на утечку, упала доступность цели. Одно и то же не повторяется, пока ситуация не изменится; вид «прогноз» включается и выключается в настройках оповещений и уходит в Telegram, Slack и исходящие вебхуки, как остальные. «Пороги» — окно с диффом перед записью: дни до заполнения диска для предупреждения и для «срочно», порог памяти и CPU, дни и рост для утечки, падение доступности в процентных пунктах.